Bias en non-discriminatie bij algoritmes
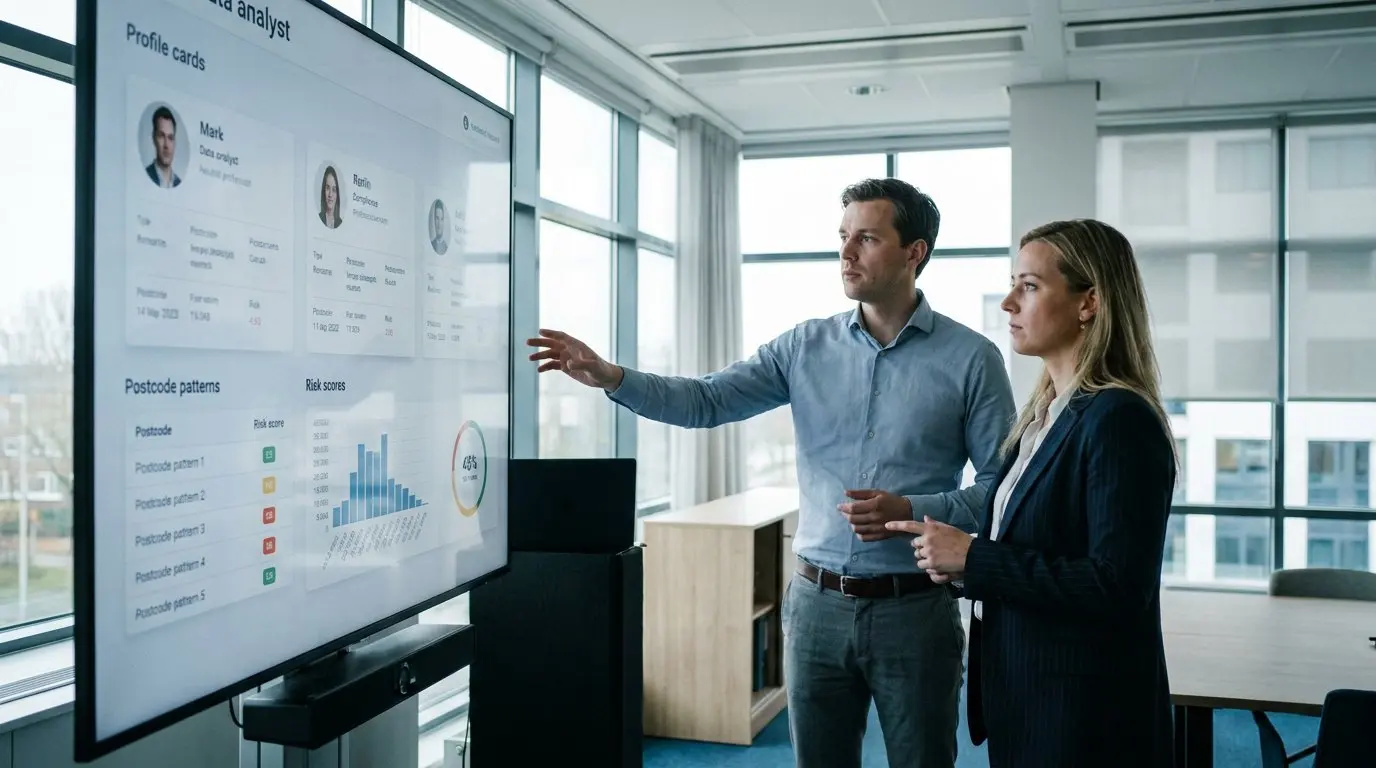
Een algoritme kan discriminerende effecten hebben, ook als kenmerken zoals afkomst of geslacht nergens letterlijk in het model staan. Ogenschijnlijk neutrale gegevens, zoals postcode, taalgebruik, opleidingsroute of historisch gedrag, kunnen namelijk als proxy fungeren en risico’s op ongelijke behandeling vergroten. Of dat ook juridisch indirect onderscheid oplevert, hangt af van de context en de uitwerking. Dat maakt algoritmebias meer dan een technisch probleem.
Bias kan ontstaan in de data, in de rekenmethode, in de manier waarop een proces is ingericht en in hoe mensen de uitkomst gebruiken. Juist daarom is non-discriminatie niet alleen een vraag voor data scientists of juristen, maar voor de hele organisatie. Op deze pagina krijg je praktische duidelijkheid: wat algoritmebias is, waar de grootste risico’s zitten, welke juridische nuances tellen en hoe je non-discriminatie beter borgt.
Wanneer is een algoritmische uitkomst discriminerend?
Een algoritmische uitkomst kan een risico op verboden onderscheid opleveren wanneer deze, binnen het toepasselijke wettelijke kader, samenhangt met een beschermde grond. Dat kan gaan om direct onderscheid, bijvoorbeeld wanneer een beschermd kenmerk zelf wordt gebruikt in een beslissing. Vaker gaat het om indirect onderscheid: een ogenschijnlijk neutraal criterium kan in de praktijk als proxy fungeren. Of dat verboden indirect onderscheid oplevert, hangt af van de vraag of personen met een beschermde grond daardoor bijzonder worden getroffen en of een objectieve rechtvaardiging ontbreekt.
Daarom is het weglaten van gevoelige kenmerken niet genoeg. Een model kan via andere data hetzelfde patroon opnieuw leren. Bij werving en selectie kan een systeem bijvoorbeeld kandidaten lager rangschikken op basis van historische succesprofielen. Bij fraude- of risicoselectie kunnen postcode of eerdere controles bepaalde groepen vaker raken. En bij gezichtsherkenning kunnen foutpercentages verschillen tussen demografische groepen; trainingsdata kunnen daarbij een rol spelen, naast bijvoorbeeld beeldkwaliteit, toepassing, drempelwaarden en het specifieke algoritme. Algoritmebias kan dus leiden tot systematische vertekening die voor specifieke groepen nadelig uitpakt.
Waar bias in de praktijk vandaan komt
Bias komt voor in allerlei soorten algoritmes: van vaste beslisregels en scoringsmodellen tot zelflerende AI en taalmodellen. Volledige afwezigheid van relevante bias is moeilijk aantoonbaar, omdat fairness- en biasrisico’s afhangen van doel, context, gebruikte gegevens en gekozen meetmethode. Waar het om gaat, is risico’s vroeg herkennen, toetsen en beperken. Die risico’s kunnen ontstaan in data en berekeningen, systemen en processen, en menselijk handelen rond het model.
Bias in data en berekeningen
Een model leert van de data die je invoert. Als die data scheef, onvolledig of verouderd zijn, neemt het systeem die vertekening mee. Bepaalde subgroepen kunnen ondervertegenwoordigd zijn in train-, test- of evaluatiedata, waardoor de uitkomst voor hen minder betrouwbaar wordt. Dat zie je bijvoorbeeld bij gezichtsherkenning, waar foutpercentages tussen groepen kunnen verschillen; de samenstelling van data kan daarbij een rol spelen, naast factoren zoals beeldkwaliteit, toepassing, drempelwaarden en het specifieke algoritme. Dat maakt datamanagement in de overheid relevant bij de beoordeling van biasrisico’s.
Ook proxies zijn riskant. Smartphonegebruik, woonomgeving of taalpatronen kunnen onbedoeld iets zeggen over sociaal-economische positie of afkomst. Zonder context lijkt dat neutrale informatie, maar in de praktijk kan het model bepaalde groepen structureel zwaarder belasten. Bovendien zegt een goede totaalscore weinig als het model per subgroep slecht presteert. Een AI-model kan dus “gemiddeld goed” lijken, terwijl het voor specifieke groepen oneerlijk uitpakt, bijvoorbeeld in werving of voorspellingen over risico’s.
Bias in systemen en processen
Bias ontstaat niet pas bij het trainen van een model. Historische ongelijkheid en institutionele keuzes zitten vaak al in de processen waarmee data worden verzameld. Als een organisatie in het verleden bepaalde wijken vaker controleerde of bepaalde profielen sneller uitnodigde, komt dat terug in de dataset en later ook in de beslisregels.
Daar komt bij dat processen niet voor iedereen even toegankelijk zijn. Digitale formulieren, taalniveau, meldprocedures of de manier waarop gegevens worden vastgelegd kunnen ervoor zorgen dat sommige groepen vaker of juist minder vaak in beeld komen. Zo ontstaat een vertekend startpunt. Bij taalmodellen en andere AI-systemen speelt nog iets extra’s: zij nemen patronen uit bestaande teksten over, inclusief stereotype verbanden. Non-discriminatie is daarom niet alleen een modelvraag, maar ook een vraag over organisatie, procesinrichting en context.
Bias in menselijk handelen rond het model
Ook wanneer een model technisch zorgvuldig is gebouwd, kunnen mensen rond de uitkomst nieuwe vertekening introduceren. Gebruikers nemen algoritmische scores soms te snel over, alsof de uitkomst objectief en volledig is. Het omgekeerde komt ook voor: iemand gebruikt de uitkomst vooral als bevestiging van wat hij of zij toch al dacht. In beide gevallen verdwijnt kritische tegenspraak.
Extra risico ontstaat wanneer een model buiten het oorspronkelijke doel wordt gebruikt. Een score die is ontwikkeld voor prioritering, wordt dan ineens gebruikt voor selectie of handhaving. Zonder duidelijke grenzen, uitleg en bevoegdheden gaat de toepassing schuiven, terwijl de betrouwbaarheid daar niet voor is getoetst.
Feedbackloops maken dat effect groter. Wie eerder is gecontroleerd, geselecteerd of afgewezen, verschijnt vaker in de data en beïnvloedt zo volgende voorspellingen. Een risicomodel kan daardoor steeds opnieuw dezelfde groepen aanwijzen, niet omdat het risico objectief hoger is, maar omdat het verleden voortdurend wordt herhaald. Bij besluiten die uitsluitend geautomatiseerd zijn en rechtsgevolgen hebben of iemand anderszins aanzienlijk treffen, gelden onder artikel 22 AVG strikte voorwaarden. Waar menselijke tussenkomst vereist of ingezet wordt, moet die betekenisvol zijn: de beoordelaar moet daadwerkelijk kunnen afwijken, relevante aanvullende informatie kunnen meewegen en signalen van discriminatie kunnen escaleren. Voor deze governance- en besluitvormingsvragen is AI voor beleidsadviseurs een logische verdieping.
Wanneer onderscheid verboden is - en wanneer een rechtvaardiging telt
Niet elk onderscheid is automatisch onrechtmatig. Organisaties mogen soms differentiëren als daar een duidelijke, legitieme reden voor is en het middel passend en noodzakelijk is. Zodra groepen ongelijk worden geraakt, ligt de lat wel hoog. Bij direct onderscheid op een beschermd kenmerk is de juridische ruimte meestal zeer beperkt en hangt die af van een specifieke wettelijke uitzondering. Bij indirect onderscheid via neutraal lijkende criteria kan een objectieve rechtvaardiging soms mogelijk zijn, maar die moet goed onderbouwd zijn.
Voor alle persoonsgegevens is een AVG-grondslag nodig. Voor ‘bijzondere persoonsgegevens’ geldt daarnaast in beginsel een verbod, tenzij een uitzondering van toepassing is en waar nodig ook een nationale wettelijke basis bestaat. Worden mogelijke discriminerende effecten zichtbaar, dan moet je de oorzaak, de ernst, de rechtmatigheid en de resterende risico’s onderzoeken en passende maatregelen nemen. Als rechtmatige inzet niet kan worden aangetoond of risico’s niet voldoende kunnen worden beperkt, schort je het gebruik op of beëindig je het.
Waarom de impact zo groot kan zijn, zeker bij risicoprofilering
Algoritmes werken op schaal. Dat is efficiënt, maar het betekent ook dat fouten of vertekeningen niet één persoon raken, maar meteen grote groepen. Juist bij risicoprofilering is dat effect groot: in handhaving, fraudeaanpak, werving of veiligheid kunnen mensen sneller worden geselecteerd voor extra controle, uitsluiting of nadere beoordeling. Dit soort toepassingen komen veel voor binnen AI in de overheid.
Het risico op indirect onderscheid ligt daar op de loer. Variabelen als postcode, inkomen, historisch toezicht of eerdere controles lijken praktisch bruikbaar, maar kunnen bestaande ongelijkheid versterken. Als een wijk in het verleden vaker is gecontroleerd, levert dat meer signalen op, waarna het model die wijk opnieuw als risicovol kan aanmerken. Zo ontstaat een zelfversterkend patroon.
De schade is bovendien niet altijd direct zichtbaar. Beperkte transparantie, complexe modellen en veranderende context maken het lastig om op tijd te zien wie structureel wordt benadeeld en waarom.
Zo beperk je het risico in elke fase van de levenscyclus
Een goede aanpak begint niet bij het model, maar bij de hele levenscyclus. Door vooraf, tijdens ontwikkeling, bij inzet en tijdens monitoring expliciet op non-discriminatie te toetsen, verklein je blinde vlekken en kun je sneller ingrijpen.
| Fase | Waar je op toetst | Concrete acties |
|---|---|---|
| Vooraf bepalen | Is een algoritme echt nodig, toegestaan en proportioneel voor dit doel? | Leg doel, doelgroep, beoogde uitkomst en acceptabele foutmarges vooraf vast; bepaal welke kenmerken en proxies onwenselijk of verboden zijn; betrek proceseigenaren, juristen, dataspecialisten, eindgebruikers en waar relevant vertegenwoordigers van getroffen groepen. |
| Ontwikkelen of inkopen | Zijn data, ontwerpkeuzes en leveranciersinformatie geschikt voor een eerlijke toepassing? | Documenteer databronnen, labelkeuzes en aannames; gebruik, waar het systeem met trainingsdata werkt, datasets die passend zijn voor het beoogde doel; toets relevante prestaties uitgesplitst naar groepen wanneer dat nodig is om risico’s op ongelijke uitkomsten te beoordelen; vraag leveranciers om uitleg over beperkingen, herkomst van data, evaluaties en mogelijkheden voor menselijke controle. Voor hoogrisico-AI gelden daarnaast expliciete eisen aan relevante, voldoende representatieve en zo foutloos en volledig mogelijke datasets. |
| Inzetten in de praktijk | Wordt het systeem gebruikt binnen het bedoelde doel en met voldoende tegenspraak? | Leg vast wie het model mag gebruiken, hoe uitkomsten worden geïnterpreteerd en wanneer een medewerker mag of moet afwijken; voorkom gebruik voor andere doelen zonder nieuwe toetsing; zorg voor training, loggen van beslissingen en een duidelijke escalatieroute bij twijfel of signalen van ongelijke behandeling. |
| Blijvend monitoren | Ontstaan er in de praktijk nieuwe vertekeningen, feedbackloops of contextverschuivingen? | Meet periodiek uitkomsten per subgroep, inclusief false positives en false negatives waar dat relevant is; analyseer feedbackloops en datadrift; actualiseer documentatie; spreek een protocol af voor onderzoek, aanpassing, opschorting of stopzetting zodra mogelijke discriminerende effecten zichtbaar worden. Betrek waar passend onafhankelijke deskundigen, gebruikers en vertegenwoordigers van mogelijk getroffen groepen bij risicoanalyse en evaluatie, en leg vast welke perspectieven zijn betrokken en welke bevindingen daaruit volgen. |
Handige toetskaders en verdiepende bronnen
- Handreikingen voor non-discriminatie by design helpen om al in de ontwerpfase scherp te krijgen welke keuzes in data, variabelen en procesinrichting risico opleveren.
- Toetsingskaders voor risicoprofilering en grondrechten zijn vooral bruikbaar wanneer algoritmes invloed hebben op selectie, toezicht, handhaving of toegang tot voorzieningen.
- Concrete kaders zoals de vrijwillige NIST AI RMF ondersteunen bij governance, meten, documenteren en het beheersen van AI-risico’s. Voor hoogrisico-AI gelden daarnaast toepasselijke AI-Act-eisen voor risicobeheer, datagovernance en monitoring.
- Voor verdere verdieping sluiten binnen SBO onderwerpen als AI-geletterdheid, AI in de overheid, datamanagement en juridische actualiteiten rond data en technologie logisch op dit thema aan. Ook de opleiding Beleidsadviseur AI is een logische vervolgstap.
Met een achtergrond in Beleids- en Organisatiewetenschappen ontwikkelt Lotte opleidingen en congresprogramma’s op het snijvlak van zorg, datagedreven werken, transformatie en innovatie. Zij vertaalt complexe maatschappelijke en organisatorische vraagstukken naar inspirerende en praktijkgerichte programma’s die professionals ondersteunen bij verandering en vernieuwing. Vanuit haar expertise in organisatieontwikkeling en innovatie richt zij zich op thema’s als toekomstbestendige zorg, digitale transformatie en (project)management. Daarbij combineert zij inhoudelijke scherpte met een creatieve en verbindende aanpak, waarbij zij samen met experts en professionals werkt aan actuele, impactvolle en vernieuwende programma’s.